
ペパボ研究所 研究員/シニア・プリンシパルエンジニアの三宅(@monochromegane)です。 VRAMに収まらない規模のMixture-of-Experts(MoE)モデルを手元のGPUで動かすために、2つのvLLMプラグインを開発しました。 本記事では、その仕組みと性能について紹介します。
はじめに
高性能なオープンウェイトモデルが相次いで公開され、これを自組織の環境で動かす選択肢が広がっています。
一方で、規模の大きなモデルを動かすためのGPUの確保は難しいままです。 例えばMoEモデルであるQwen3.6-35B-A3B-FP8は、40のMoE層それぞれに256のエキスパートを持ち、エキスパートの重みだけで約30GiBに達します。 トークンごとに使われるエキスパートは一部だけですが、どれが選ばれるかは事前にわからないため、すべてをVRAMに常駐させることになります。
そこで、VRAMに収まらない重みをホストRAMとSSDへ退避して、必要な分だけをVRAMに出し入れする仕組みを、vLLMのプラグインとして実装しました。 本記事で紹介するのは次の2つです。
- vllm-expert-pager:MoEのエキスパート重みをVRAM/RAM/SSDの3階層でページングする
- vllm-ngram-pager:Qwen3.8-Flash-Next-FP8のn-gram埋め込みテーブルをSSD上のモデルファイルから直接読み出す
vllm-expert-pagerでは、同程度のVRAM使用量におけるvLLM標準のオフロード機能と比べて、デコード速度が5.8倍となりました。 また、2つを併用することで、より大きなモデルであるQwen3.8-Flash-Next-FP8を、RTX 4090(VRAM 24GB)の1枚で動かせることを確認しました。
以降では、既存の対処法との位置づけを整理したうえで、プラグインの主要な機能と推論性能の評価結果を示します。
取り組みの位置づけ
VRAMに収まらないモデルを動かす方法は、重みのデータ量を減らすか、重みの置き場所を工夫するかに分かれます。
データ量を減らす方法の代表が量子化です。 効果は大きい一方で、ビット数を減らすほど精度が劣化します。 また、低ビットの量子化モデルは、モデルの提供元ではなく第三者が公開したものが多くなります。 元のモデルの公開からの時間差や、再配布にあたってのライセンスの扱いも、運用上は考慮が必要です。 そこで本記事では、提供元が公式に配布する量子化としてFP8を前提とし、置き場所の工夫に取り組みます。
置き場所の工夫は、配置を起動時に決めてしまう方式と、実行時に入れ替える方式に分かれます。
起動時に決める方式の例が、vLLMの--cpu-offload-gbです。
VRAMに収まらない分をホストRAMへ置き、必要になるたびに転送します。
どの重みをVRAMに残すかは起動時に決まり、使われ方に応じて入れ替えることはありません。
退避先もホストRAMまでです。
実行時に入れ替える方式は、よく使われるエキスパートをVRAMに残し、退避先をSSDまで広げます。 antirez氏によるDS4や、kishida氏によるQuestWendがこれにあたります。 いずれも実行時の使われ方に応じてVRAM上のエキスパートを入れ替え、収まらない分をSSDから読み出します。 ただし、これらは推論エンジンそのものとして実装されているため、採用するとサービングの部分もそのエンジンのものになります。 リクエストのスケジューリングやメモリ管理、新しいモデルへの対応まで、vLLMに積み重ねられてきた実装は使わないことになります。
本記事の取り組みは、次の3つを同時に満たすことを目指しました。
- 提供元が公式に配布するFP8の重みをそのまま使う
- 使われ方に応じてVRAMの内容を入れ替え、退避先をSSDまで広げる
- サービングはvLLMに任せ、重みの置き場所だけを担うプラグインとして実装する
以降では、FP8のモデルを対象とするプラグインとして、VRAMとSSDをどう使うかという仕組みを中心に説明し、その評価を示します。
プラグインの仕組み
vllm-expert-pagerによるエキスパート重みの階層ページングの全体像を、図1に示します。
図1: エキスパート重みの階層ページング
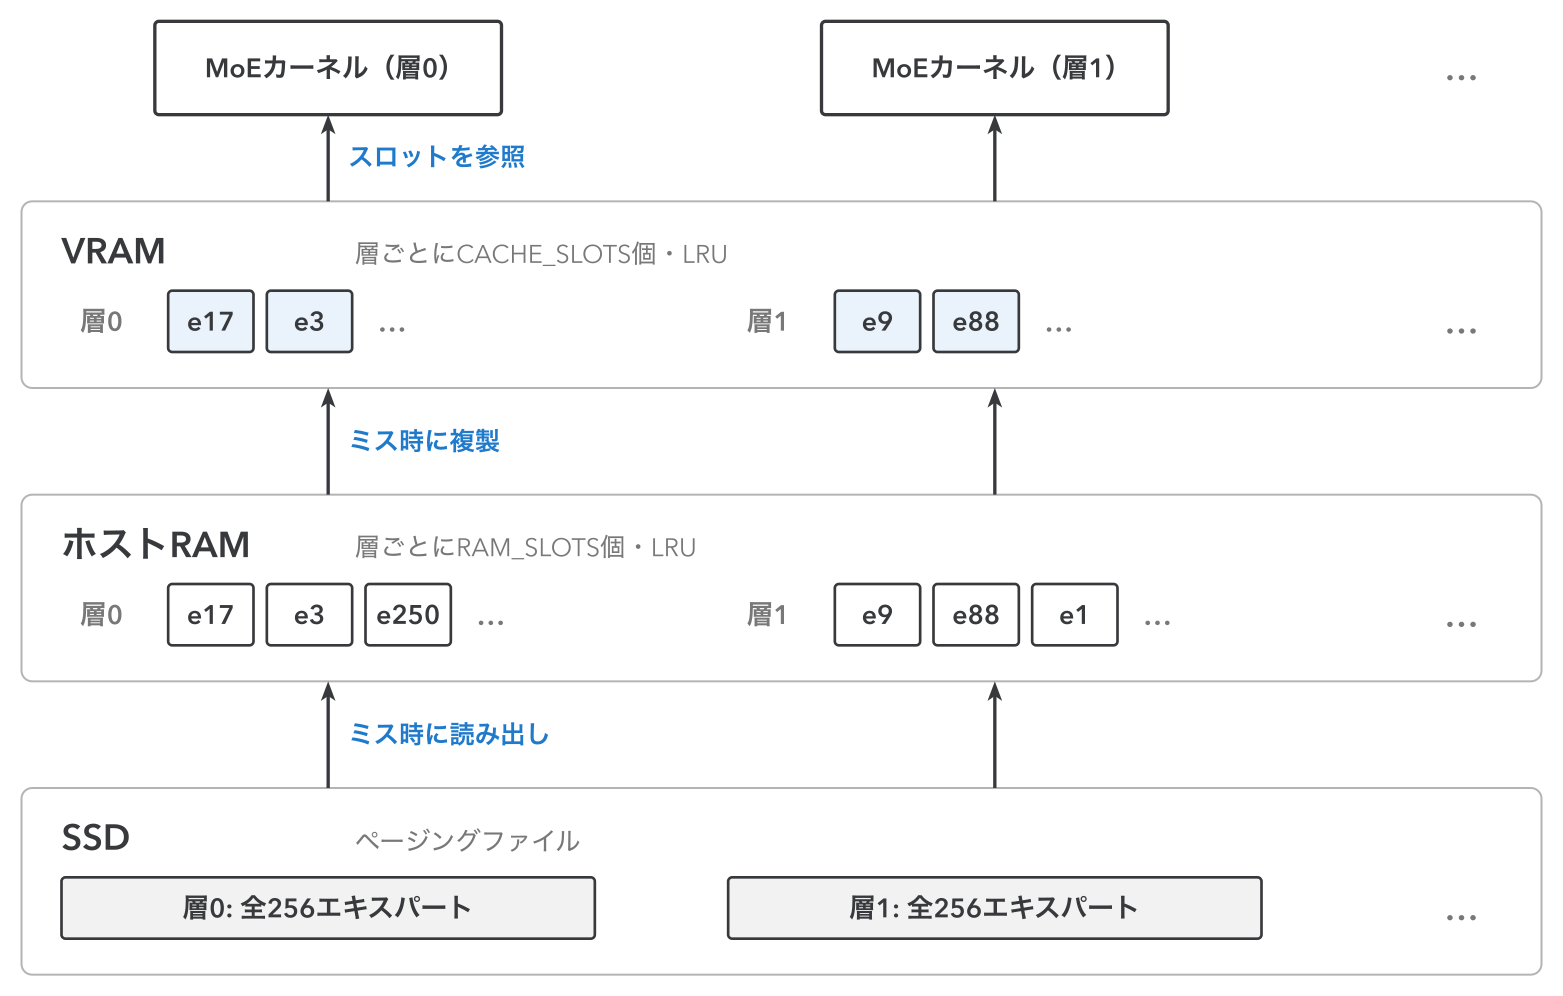
なお、この3階層は、VRAM、ホストRAM、SSDの順に容量が大きく、読み出しに時間がかかることを前提としています。
エキスパート重みの階層ページング
MoEモデルでは、トークンごとに使われるエキスパートはごく一部であり、直前に選ばれたものが再び選ばれやすいという偏りがあります。 vllm-expert-pagerは、この偏りをキャッシュの局所性とみなし、エキスパートの重みをVRAMとホストRAMに分けて管理します。 VRAMを主記憶、ホストRAMをその退避先に見立てた、OSの仮想記憶におけるページングに相当します。
各MoE層は、VRAMとホストRAMのそれぞれに、自分専用のスロット群を持ちます。 1つのスロットが1つのエキスパートの重みを保持し、どちらの階層もLRUで管理します。 スロット数はMoE層ごとに設定できます。 必要なエキスパートがVRAMになければ、RAMのスロットから複製します。
なお、プレフィル時のように、1ステップで必要なエキスパートがスロット数を超える場合は、その層に限り、必要な分をすべて収める作業用バッファへ切り替えます。
SSD階層
ホストRAMにもすべてのエキスパートが収まらない場合は、退避先としてSSDも使います。 起動時に、すべての層のすべてのエキスパートを収めたページングファイルをSSDへ書き出しておきます。 必要なエキスパートがRAMにもなければ、ホスト側のスレッドがこのファイルから読み出し、RAMのスロットへ載せます。
重みの圧縮
SSD階層を使う構成では、RAMとSSDに置く重みを可逆圧縮できます。 FP8の値は指数部に偏りがあるため、エキスパートの重み行列の行ごとに指数部をハフマン符号化し、VRAMへ複製した直後にGPU側で展開します。 これにより、RAMとSSDの使用量が1割ほど減り、同じRAM容量でより多くのエキスパートを保持できます。 一方で展開のオーバーヘッドがかかるため、設定で無効にもできます。 容量と速度のどちらを取るかは、後述の評価で構成ごとに示します。
n-gramテーブルのページング
Qwen3.8-Flash-Nextには、エキスパートの重みとは別に、VRAMを圧迫する要素としてn-gram埋め込みテーブルがあります。 vllm-ngram-pagerプラグインは、このテーブルをVRAMに載せず、SSD上のモデルファイルをmmapして、各ステップで必要になった行だけを集めます。 一度の転送量が少ないため、現状はvllm-expert-pagerのような独自のLRU管理を持たず、OSのページキャッシュをそのままRAM階層として使っています。
評価
環境と方法
評価にはRTX 4090(VRAM 24GB)を用い、WSL2上のvLLM 0.29.0で測定しました。
ホストRAMは64GBで、WSL2から見えるのは約54GBです。
クライアントにはvllm bench serveを用い、randomデータセットで並列数1、入力1024トークン、出力256トークン、4プロンプトの条件としています。
出力は--ignore-eosで256トークンに固定し、--temperature 0を指定しました。
構成ごとにキャッシュを暖めるための実行を1回挟んだうえで2回計測し、2回目の結果を採用しました。
指標には、出力トークンあたりの時間(TPOT)、最初のトークンまでの時間(TTFT)、および秒間出力トークン数(tok/s)を用いています。
各表の使用量は、いずれもエキスパートの重みに使った分で、起動時のログから求めました。
VRAM使用量は、vLLMが報告する重みのGPUメモリ使用量から、エキスパート以外の重みの分を引いた値です。
エキスパート以外の重みは、35Bではすべてのエキスパートをホストへ退避した--cpu-offload-gb 32の実測値4.25GiB、Qwen3.8-Flash-Next-FP8ではスロット数の異なる2つの構成から求めた約9.7GiBです。
RAM使用量とSSD使用量は、プラグインが起動時に出力する確保量とページングファイルのサイズです。
なお、表3のQwen3.8-Flash-Next-FP8のみ、vLLM 0.29.0では起動できない(vllm-project/vllm#55341で修正済み)ため、当該修正を含むmainのビルド(0.28.1rc1.dev583+g114abd1c1)で測定しました。
階層ページングの効果
Qwen3.6-35B-A3B-FP8を--max-model-len 4096 --max-num-seqs 1で起動し、vLLM標準の--cpu-offload-gbと比較しました。
比較対象を揃えるため、--cpu-offload-gbには退避対象をエキスパート重みに限る--cpu-offload-params w13_weight w2_weightを併せて指定しています。
結果を表1に示します。
表中のCACHE_SLOTSとRAM_SLOTSは、それぞれVRAM階層とRAM階層の、MoE層あたりのスロット数です。
表1: Qwen3.6-35B-A3B-FP8における推論性能
| 構成 | VRAM使用量 | RAM使用量 | SSD使用量 | TPOT | TTFT | tok/s |
|---|---|---|---|---|---|---|
--cpu-offload-gb 32 |
0 GiB | 30 GiB | 未使用 | 90.1 ms | 2719 ms | 10.0 |
--cpu-offload-gb 17 |
13.0 GiB | 17 GiB | 未使用 | 54.0 ms | 1694 ms | 16.6 |
CACHE_SLOTS=32, RAM_SLOTS=256 |
4.1 GiB | 30.4 GiB | 未使用 | 17.4 ms | 964 ms | 47.4 |
CACHE_SLOTS=102, RAM_SLOTS=256 |
12.3 GiB | 30.4 GiB | 未使用 | 9.3 ms | 779 ms | 81.2 |
同程度のVRAM使用量にあたるCACHE_SLOTS=102と--cpu-offload-gb 17を比べると、デコード速度は5.8倍となりました。
すべてのエキスパートをホストへ退避した--cpu-offload-gb 32に対しては9.7倍です。
VRAM使用量を4.1GiBに抑えたCACHE_SLOTS=32でも、--cpu-offload-gb 17の3.1倍が出ています。
SSD階層のコスト
続いて、RAM階層のスロット数をエキスパート数より少なくし、残りをSSDから読み出す構成を測定しました。 結果を表2に示します。
表2: SSD階層を使う場合の性能
| 構成 | VRAM使用量 | RAM使用量 | SSD使用量 | TPOT | TTFT | tok/s |
|---|---|---|---|---|---|---|
CACHE_SLOTS=32, RAM_SLOTS=256 |
4.1 GiB | 30.4 GiB | 未使用 | 17.4 ms | 964 ms | 47.4 |
CACHE_SLOTS=32, RAM_SLOTS=128 |
4.1 GiB | 15.4 GiB | 30.0 GiB | 22.9 ms | 2492 ms | 30.7 |
エキスパートのRAM使用量を30.4GiBから15.4GiBへ半減させる代償として、TPOTが5.5ms増加しました。 さらに、TTFTは964msから2492msへ大きく増加しています。 これは、プレフィルではRAMに存在しないエキスパートをほぼすべてSSDから読み出すことになるためと考えられます。
35BではエキスパートがすべてホストRAMに収まるためSSD階層を使う必要はありませんが、次に示すQwen3.8-Flash-Next-FP8のように、ホストRAMにも収まらない規模のモデルでは必要になります。
n-gramテーブルのページングによる実行
2つのプラグインを併用し、Qwen3.8-Flash-Next-FP8をRTX 4090の1枚で実行しました。 このモデルは48層それぞれに512のエキスパートを持ち、エキスパートの重みが112.5GiB、n-gram埋め込みテーブルが47.7GiBあります。 いずれもVRAMには収まりません。 そこで、エキスパートの重みはvllm-expert-pagerがホストRAMとSSDに、n-gram埋め込みテーブルはvllm-ngram-pagerがSSD上のモデルファイルに置いたまま実行します。 この構成では、重みの圧縮も有効にしています。 結果を表3に示します。
表3: Qwen3.8-Flash-Next-FP8における推論性能
| 構成 | VRAM使用量 | RAM使用量 | SSD使用量 | TPOT | TTFT | tok/s |
|---|---|---|---|---|---|---|
CACHE_SLOTS=46, RAM_SLOTS=232 |
10.7 GiB | 45.4 GiB | 99.0 GiB | 60.7 ms | 4978 ms | 12.5 |
比較対象となる構成がないため絶対値のみですが、VRAM 24GBの1枚で、112.5GiBのエキスパート重みを持つモデルがサービングできています。 スロット数は、このホストRAMで確保できる上限です。 これは、n-gramテーブルのページキャッシュとして使う分を残す必要があるためです。
重みの圧縮の効果
最後に、RAMとSSDに置く重みの圧縮について、2つのモデルで効果を比べました。
スロット数は、圧縮なしでもホストRAMに収まる値に揃えました。
35BはCACHE_SLOTS=32, RAM_SLOTS=128、Flash-NextはCACHE_SLOTS=38, RAM_SLOTS=192です。
結果を表4に示します。
表4: 圧縮の有無による違い
| 構成 | VRAM使用量 | RAM使用量 | SSD使用量 | TPOT | TTFT | tok/s |
|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B-FP8、圧縮なし | 4.1 GiB | 15.4 GiB | 30.0 GiB | 22.9 ms | 2492 ms | 30.7 |
| Qwen3.6-35B-A3B-FP8、圧縮あり | 4.2 GiB | 13.7 GiB | 26.7 GiB | 24.3 ms | 2318 ms | 30.1 |
| Qwen3.8-Flash-Next-FP8、圧縮なし | 8.7 GiB | 42.8 GiB | 112.5 GiB | 67.4 ms | 6214 ms | 10.9 |
| Qwen3.8-Flash-Next-FP8、圧縮あり | 9.0 GiB | 37.6 GiB | 99.0 GiB | 67.3 ms | 5551 ms | 11.3 |
容量の削減はどちらのモデルでも同程度で、RAMとSSDの使用量がいずれも1割強減りました。 VRAM使用量だけはわずかに増えますが、これは展開に使う符号表をVRAMに常駐させるためです。 読み出すバイト数が減るため、TTFTもどちらも短くなっています。
一方で、デコード速度への影響はモデルによって異なりました。 35BではTPOTが1.4ms(6%)増えるのに対し、Flash-Nextではほとんど変わりません。 Flash-Nextはデコード時間の大半がSSDの読み出し待ちであり、展開の処理がその待ち時間の内側で終わるためと考えられます。
したがって、ホストRAMが先に足りなくなる場合やSSDの読み出し待ちが支配的な場合は圧縮を有効にし、RAMに余裕があってデコード速度を優先するなら無効にする、という使い分けが良さそうです。
まとめ
本記事では、VRAMに収まらない重みを階層的にページングすることで、規模の大きなMoEモデルを手元のGPUでサービングする取り組みを紹介しました。
提供元が配布するFP8の重みをそのまま用い、使われ方に応じてVRAMの内容を入れ替えながら、退避先をSSDまで広げています。
サービングはvLLMに任せ、プラグインが担うのは重みの置き場所だけであるため、vLLMの実装をそのまま使えます。
現時点での制約として、複数GPUへの分散には対応していません。
また、vllm-expert-pagerが対象とするのはFP8で保存されたQwen系のMoEモデルであり、SSD階層はO_DIRECTを用いるためLinuxが必要です。
いずれのプラグインもMITライセンスで公開しています。よければ使ってみてください。 ペパボ研究所では、研究開発組織としての立場から、今後もこのような実応用を見据えた取り組みとその知見を公開していきたいと考えています。
【PR】パートナー積極採用中!
ペパボ研究所では、新しいパートナーを求めています。詳細については、当研究所のトップページをご覧ください。

